Представьте ситуацию: ваш бэкенд работает идеально на нагрузочном тестировании, но стоит выпустить его в продакшн, и через час сервер падает. Причина банальна - кто-то написал скрипт, который шлет 1000 запросов в секунду вместо ожидаемых 5. Или просто вирусный пост в Twitter привлек толпу пользователей, которые начали обновлять страницу каждые две секунды. Без ограничения частоты запросов (rate limiting) ваш сервис становится мишенью для DDoS-атак или просто случайных ошибок клиентов. Rate limiting - это не просто «фишка» для больших компаний вроде Twitter или GitHub; это базовая гигиена любого современного REST API.
| Аспект | Описание |
|---|---|
| Цель | Защита ресурсов сервера и обеспечение справедливости доступа |
| Механизм | Отслеживание количества запросов от одного клиента за определенный период времени |
| Результат нарушения | Возврат HTTP статуса 429 Too Many Requests |
Зачем вообще нужны лимиты?
Главная ошибка новичков - думать, что лимиты нужны только против хакеров. На самом деле, они защищают систему от самих разработчиков. Клиенты часто пишут код с багами: бесконечные циклы при ретраях, отсутствие кэширования на стороне клиента, агрессивное поллингирование. Если у вас нет защиты, один такой клиент может съесть все ресурсы базы данных, и остальные пользователи начнут получать таймауты.
Еще одна причина - бизнес-логика. Вы можете продавать доступ к API по тарифам: Free, Pro, Enterprise. Ограничение частоты позволяет четко разграничить эти уровни. Бесплатный пользователь получает 100 запросов в минуту, платный - 1000. Это прямой путь к монетизации инфраструктуры.
Основные алгоритмы ограничения частоты
Не существует единственно правильного способа считать запросы. Выбор алгоритма зависит от того, насколько строго вам нужно контролировать нагрузку и сколько памяти вы готовы потратить.
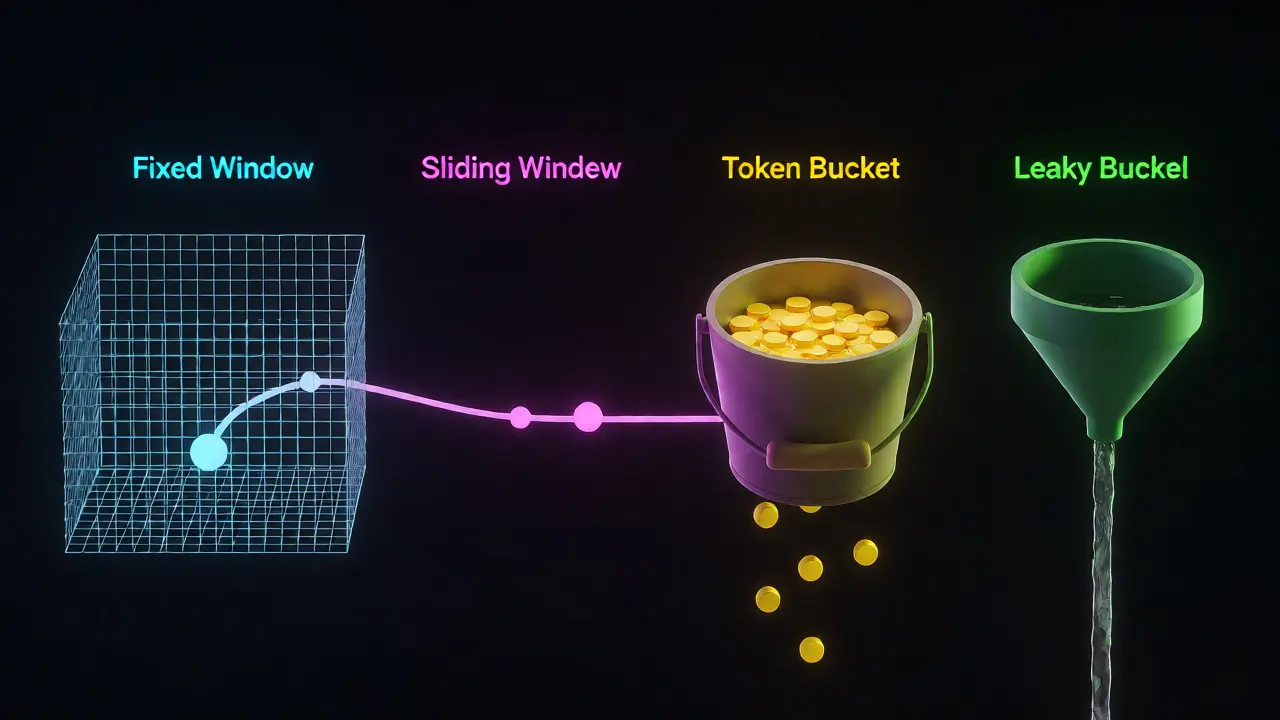
Fixed Window Counter (Фиксированное окно)
Самый простой подход. Вы делите время на фиксированные интервалы (например, минуты). В начале каждой минуты счетчик обнуляется. Каждый запрос увеличивает счетчик. Если он превышает лимит - отказ.
Fixed Window - это алгоритм подсчета запросов в дискретных временных интервалах без учета их распределения внутри окна. Его главный минус - эффект «края окна». Представьте лимит 100 запросов в минуту. Клиент отправляет 100 запросов в последние секунды первой минуты и сразу 100 запросов в первые секунды второй минуты. За 2 секунды он сделал 200 запросов, хотя формально не нарушил правило ни в одном из окон. Для большинства приложений это приемлемо, но для чувствительных к пиковым нагрузкам систем - нет.
Sliding Window Log (Скользящее логарифмическое окно)
Этот метод хранит точное время каждого запроса в очереди (обычно Redis Sorted Set). Когда приходит новый запрос, система удаляет записи старше текущего момента минус размер окна и считает оставшиеся. Если их больше лимита - отказ.
Точность здесь максимальная, но цена высока. Хранить каждый запрос занимает память. Если у вас миллионы пользователей, а лимит высокий, Redis будет задыхаться. Этот метод лучше использовать для дорогих операций, где важна абсолютная честность, например, оплата транзакций.
Token Bucket (Ведро с токенами)
Пожалуй, самый популярный алгоритм в современных API. Представьте ведро, которое наполняется каплями (токенами) с постоянной скоростью. Максимальный объем ведра определяет «burst capacity» (пиковую пропускную способность). Каждый запрос требует забрать токен. Если ведро пусто - запрос отклоняется.
Token Bucket - это алгоритм, позволяющий кратковременные всплески трафика выше среднего уровня, ограничивая среднюю скорость долгосрочно. Он идеален для клиентских приложений, которые могут работать пакетами. Например, мобильное приложение синхронизирует данные: сначала идет серия быстрых запросов (заполнение ведра расходуется), затем пауза (ведро пополняется).
Leaky Bucket (Протекающее ведро)
Похоже на Token Bucket, но работает иначе. Запросы падают в ведро, а оно «протекает» с постоянной скоростью. Если ведро переполняется, новые запросы теряются. Разница в том, что Leaky Bucket всегда отдает трафик равномерно, сглаживая пики. Token Bucket разрешает пики, если есть запас токенов. Выбирайте Leaky Bucket, если ваш бэкенд любит стабильность и ненавидит скачки нагрузки.
Как реализовать это технически?
Хранить состояние лимитов в памяти процесса приложения - плохая идея для микросервисной архитектуры. Как только вы запустите два инстанса сервиса, клиенты будут видеть разные лимиты в зависимости от того, на какой сервер попадет их запрос. Поэтому стандарт де-факто - использование распределенного кэша, чаще всего Redis.
Типичный флоу middleware выглядит так:
- Извлекаем идентификатор клиента (IP, API Key, User ID).
- Формируем ключ для Redis, например: `ratelimit:{api_key}:{endpoint}`.
- Выполняем атомарную операцию INCR или Lua-скрипт для проверки лимита.
- Если лимит превышен, возвращаем HTTP 429 и заголовки с информацией о восстановлении.
- Если лимит не превышен, пропускаем запрос дальше и добавляем заголовки с остатком лимита.
Важно использовать Lua-скрипты в Redis для сложных алгоритмов (как Token Bucket), чтобы избежать гонок данных между потоками. Обычный GET + SET может привести к тому, что два параллельных запроса прочитают одно значение, оба решат, что лимит не исчерпан, и оба запишут новое значение, потеряв один инкремент.
Стандарты заголовков ответа
Чтобы клиент мог корректно обрабатывать отказы, важно говорить с ним на одном языке. Не придумывайте свои JSON-структуры для ошибок лимита. Используйте стандартные HTTP-заголовки, предложенные IETF (Internet Engineering Task Force).
| Заголовок | Назначение |
|---|---|
X-RateLimit-Limit | Максимальное количество запросов, разрешенное в текущем окне. |
X-RateLimit-Remaining | Количество запросов, оставшихся до достижения лимита. |
X-RateLimit-Reset | Unix timestamp времени, когда счетчик обнулится. |
Retry-After | Сколько секунд ждать перед повторной попыткой (обязательно при статусе 429). |
Новый стандарт RateLimit (без префикса X-) постепенно заменяет старые варианты, но поддержка старых заголовков пока обязательна для совместимости со старыми клиентами. Всегда отдавайте Retry-After, даже если клиент не просил его явно. Это спасет нервы разработчикам, пишущим интеграции.
Где брать идентификатор клиента?
Это вопрос безопасности и логики. Самый простой вариант - IP-адрес. Но он имеет минусы: NAT в крупных офисах объединяет тысячи пользователей под одним IP, а динамические IP мобильных операторов меняются часто. Более надежный способ - API Key или OAuth Token.
Для авторизованных пользователей используйте их User ID. Для анонимных гостей - IP. Часто применяют гибридный подход: общий лимит на IP для защиты от ботов и персональный лимит на аккаунт для бизнес-логики. Помните, что если вы используете Cloudflare или AWS ALB перед вашим сервером, реальный IP клиента находится в заголовке X-Forwarded-For, а не в REMOTE_ADDR. Игнорирование этого факта приведет к тому, что весь ваш трафик будет казаться идущим с одного IP балансировщика.
Частые ошибки при внедрении
- Блокировка на уровне всего сервиса. Лимиты должны быть гранулярными. Ошибка поиска не должна блокировать возможность создать профиль. Разделяйте лимиты по эндпоинтам или группам эндпоинтов.
- Игнорирование методов чтения. GET-запросы обычно дешевле, чем POST или DELETE. Можно ставить более жесткие лимиты на методы изменения данных.
- Отсутствие grace period. Если клиент случайно превысил лимит на один запрос, не блокируйте его на всю минуту. Позвольте ему сделать следующий запрос чуть позже или используйте мягкий алгоритм типа Token Bucket.
- Жесткая связь с бизнес-логикой. Middleware rate limiting должен выполняться до сложной бизнес-логики и обращений к БД, но после аутентификации (если лимит зависит от пользователя). Так вы сэкономите ресурсы сервера, отсекая лишнее на раннем этапе.
Инструменты и библиотеки
Не обязательно писать всё с нуля. Для Node.js популярны библиотеки express-rate-limit и node-rate-limiter-flexible. В Python экосистема Flask/Django предлагает Flask-Limiter и django-ratelimit. Go разработчики часто используют пакет golang.org/x/time/rate или специализированные решения вроде ulule/limiter.
Если вы используете Kubernetes, можно настроить лимиты на уровне Ingress Controller (Nginx Ingress, Traefik) или Service Mesh (Istio, Linkerd). Это снимает нагрузку с приложения, но лишает гибкости в настройке сложных правил (например, разных лимитов для разных параметров запроса).
Какой HTTP код возвращать при превышении лимита?
Стандартный код - 429 Too Many Requests. Раньше использовали 503 Service Unavailable, но это семантически неверно, так как сервис доступен, просто временно перегружен конкретным клиентом. Код 429 четко дает понять клиенту, что проблема в нем, и он может попробовать снова позже.
Нужно ли ограничивать статические файлы через REST API?
Обычно нет. Статические ассеты (CSS, JS, изображения) обслуживаются CDN или веб-серверами (Nginx/Apache) напрямую, минуя логику приложения. Ограничения для них настраиваются на уровне веб-сервера или CDN (например, Cloudflare Rate Limiting Rules), так как там они дешевле и эффективнее.
Как быть с внутренними микросервисами? Нужны ли им лимиты?
Да, но правила другие. Между внутренними сервисами лимиты нужны для предотвращения каскадных сбоев (cascading failures). Если сервис А упадет, а сервис Б продолжит слать ему запросы с прежней интенсивностью, он может добить А окончательно. Здесь лучше использовать Circuit Breaker паттерн в сочетании с мягкими лимитами или backpressure механизмами.
Можно ли менять лимиты динамически без перезапуска сервера?
Да, это лучшая практика. Храните конфигурацию лимитов в базе данных или конфиг-центре (Consul, etcd). Приложение должно периодически перечитывать эти настройки или подписываться на события их изменения. Это позволит оперативно реагировать на атаки или маркетинговые акции, увеличивая лимиты для VIP-клиентов на лету.
Что делать, если Redis недоступен?
Включите fail-open режим. Если кэш недоступен, лучше пропустить запрос, чем заблокировать всех пользователей. Однако для критических операций (платежи) лучше включить fail-close режим или использовать локальную in-memory fallback с грубыми оценками, понимая, что точность будет низкой.