Вы когда-нибудь ловили себя на мысли, что ваш сервер с GPU простаивает, пока CPU плавится от повторных вычислений одного и того же запроса? Это классическая боль продакшн-ML. Модель обучена, веса загружены, но каждый новый пользовательский запрос заставляет процессор снова и снова выполнять одни и те же матричные умножения. Если вы работаете с инференсом в Python, вы знаете, насколько дорогим может быть пропускной поток без грамотного кеширования.
В этой статье мы разберем не абстрактные теории, а конкретные стратегии, которые позволяют сократить нагрузку на процессор на 40-90% в зависимости от типа данных. Мы посмотрим на то, как правильно организовать слой кеша между API и моделью, какие библиотеки выбрать для хранения хешей и предсказаний, и где кроются подводные камни при работе с динамическими данными. Забудьте о сложных архитектурных изысканиях - здесь только практичные решения для реальных задач.
Зачем вообще кешировать инференс?
Давайте честно: запуск нейросети даже на хорошем железе - это дорого. Даже если у вас стоит современный чип, стоимость вызова модели складывается из нескольких факторов: загрузки весов (если они не в памяти), преобразования входных данных, самих вычислений и постобработки результата. Для простых моделей вроде линейной регрессии это может быть миллисекунды, но для трансформеров или ансамблей деревьев решений счет идет на десятки и сотни миллисекунд.
Теперь представьте типичный сценарий e-commerce. Пользователь А смотрит товар X. Система предсказывает ему похожие товары. Через минуту пользователь Б открывает тот же товар X. Зачем нам снова гонять модель через весь граф вычислений, если результат будет идентичным? Кеширование ответов инференса превращает эту задачу из вычислительной в задачу поиска по таблице. Поиск занимает микросекунды против миллисекунд на вычисления.
Но есть нюанс. Не все данные можно кешировать. Если ваша модель зависит от времени суток или геолокации пользователя, простой ключ «ID товара» не сработает. Здесь начинается инженерия: нужно понять, какие части входа являются статичными, а какие меняются. Именно этот баланс определяет вашу стратегию экономии CPU.
Стратегия №1: Хеш-таблицы в памяти (LRU Cache)
Самый быстрый способ начать кешировать - использовать встроенные механизмы Python или легковесные библиотеки вроде functools.lru_cache или cachetools. Этот подход идеально подходит для локальных скриптов, прототипов или сервисов с небольшим объемом уникальных запросов.
Принцип прост: вы оборачиваете функцию предсказания декоратором, который сохраняет последние N результатов в оперативную память процесса. Если функция вызывается с теми же аргументами, она возвращает сохраненное значение, не трогая модель.
from functools import lru_cache
import time

# Имитация дорогой функции инференса
def expensive_inference(data_hash):
    time.sleep(0.1) # Симуляция работы CPU/GPU
    return f"Result for {data_hash}"

@lru_cache(maxsize=128)
def cached_inference(data_hash):
    return expensive_inference(data_hash)

# Первый вызов - медленный
start = time.time()
cached_inference("user_1_item_A")
print(f"First call: {time.time() - start:.4f}s")

# Второй вызов - мгновенный
start = time.time()
cached_inference("user_1_item_A")
print(f"Second call: {time.time() - start:.4f}s")
Почему это экономит CPU? Потому что вы полностью исключаете этап выполнения кода модели. Но у этого метода есть жесткие ограничения. Во-первых, кеш живет только внутри одного процесса. Если вы используете Gunicorn с несколькими воркерами, каждый воркер будет иметь свой собственный кеш. Вы получите дублирование памяти и неравномерную нагрузку. Во-вторых, размер кеша ограничен RAM вашего контейнера или сервера. Как только лимит исчерпан, старые записи удаляются (алгоритм LRU - Least Recently Used).
Когда это работает лучше всего? Когда у вас монолитный сервис на одном сервере, и количество уникальных комбинаций входов невелико (например, рекомендации для топ-100 товаров). В остальных случаях вам нужен внешний стор.
Стратегия №2: Внешние сторижи (Redis и Memcached)
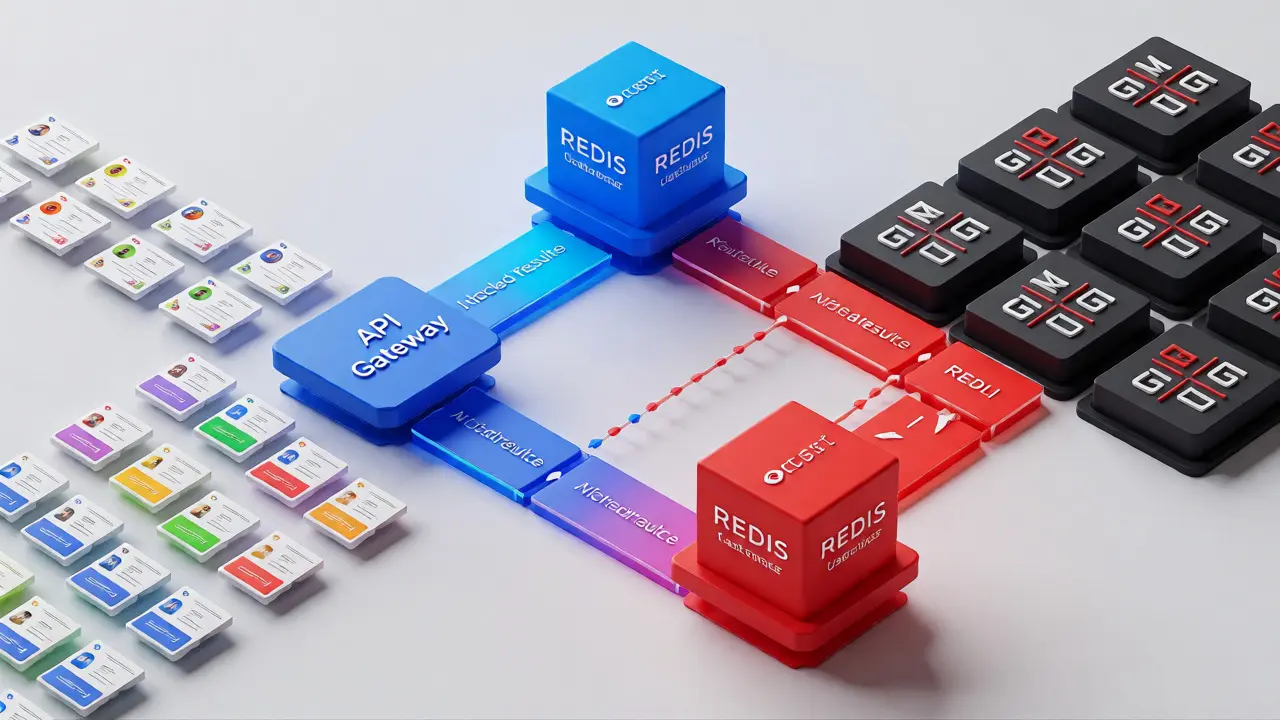
Для распределенных систем, где запросы приходят на разные инстансы, внутренний кеш бесполезен. Вам нужен единый источник правды. Стандарт де-факто здесь - Redis. Это in-memory хранилище структур данных, которое поддерживает сетевое взаимодействие и имеет микросекундную задержку.
Архитектура выглядит так: запрос приходит в API -> API формирует ключ -> проверяет Redis -> если ключа нет, вызывает модель -> пишет результат в Redis -> отдает ответ пользователю.
| Критерий | In-Memory (LRU) | Redis / Memcached | Диск (SQLite/RocksDB) |
|---|---|---|---|
| Скорость доступа | Наносекунды | Миллисекунды (сеть + сериализация) | Миллисекунды (I/O операции) |
| Объем хранения | Ограничен RAM процесса | Гигабайты/Terabytes (кластер) | Терабайты (дисковое пространство) |
| Распределение | Нет (per-process) | Да (shared across services) | Частично (зависит от реализации) |
| Сложность внедрения | Низкая (декоратор) | Средняя (клиент, сеть, сериализация) | Высокая (управление файлами, блокировки) |
| Стоимость эксплуатации | Бесплатно (RAM) | Плата за инфраструктуру Redis | Дешево (диск дешевле RAM) |
Главная проблема при работе с внешним кешем - сериализация. Нейросети часто возвращают сложные объекты: numpy-массивы, словари с тензорами или собственные классы. JSON не умеет работать с numpy напрямую. Вам придется либо конвертировать массивы в списки (что медленно и увеличивает объем данных), либо использовать бинарные форматы вроде Pickle или MessagePack.
Совет от практика: никогда не используйте `pickle` с недоверенными данными в продакшене из соображений безопасности, но для внутреннего использования он самый быстрый. Если безопасность критична, переходите на `msgpack` или `protobuf`. Также помните, что передача больших массивов по сети может занять больше времени, чем сам инференс на локальной машине. Поэтому кешируйте только те результаты, которые действительно дороги в вычислении.
Как правильно формировать ключ кеша?
Это самая важная часть всей архитектуры. Если ключ будет неправильным, вы получите либо «cache miss» (кеш не сработал, CPU нагружен зря), либо «stale data» (старые данные, бизнес-логика сломана).
Идеальный ключ должен содержать всю информацию, которая влияет на выход модели. Обычно это:
- Версия модели (например,
v2.1). Если вы переобучили модель, старый кеш должен стать невалидным. - Префикс задачи (
classification,regression). - Хеш входных данных. Здесь важно не просто взять строку, а нормализовать её. Например, если вход - это список тегов, его порядок не должен влиять на результат, поэтому перед хешированием список нужно отсортировать.
Пример формирования надежного ключа:
import hashlib
import json

def generate_cache_key(model_version, input_data):
    # 1. Нормализуем данные (пример для словаря)
    sorted_data = json.dumps(input_data, sort_keys=True)

    # 2. Создаем хеш SHA256 (быстрый и надежный)
    hash_object = hashlib.sha256(sorted_data.encode('utf-8'))
    hex_dig = hash_object.hexdigest()

    # 3. Формируем итоговый ключ
    return f"ml:{model_version}:pred:{hex_dig}"
Почему SHA256? Коллизии (когда два разных входа дают одинаковый хеш) в нем практически невозможны для разумных объемов данных. MD5 быстрее, но риск коллизий выше, а для ML-задач цена ошибки высока.
Инвалидация кеша: когда выбрасывать данные?
Записать в кеш легко. Труднее понять, когда запись стала мусором. Стратегии инвалидации бывают двух типов: TTL (Time To Live) и событийная инвалидация.
TTL - это установка времени жизни записи. Например, вы решаете, что прогноз погоды актуален 15 минут. Вы пишете в Redis ключ с таймаутом 900 секунд. Это просто, но грубо. Если данные изменились через минуту, вы будете отдавать старое значение следующие 14 минут.
Событийная инвалидация сложнее, но точнее. Она требует триггеров. Например, если вы обновляете профиль пользователя, который используется как фича в модели, вам нужно явно удалить все ключи, связанные с этим пользователем. В Redis это можно сделать через паттерны (DEL ml:v1:user_123*), но это операция O(N), которая может заблокировать базу данных при большом количестве ключей. Лучше хранить индекс соответствий или использовать структуры данных Set в Redis для группировки ключей.
Есть гибридный подход: короткий TTL (например, 5 минут) плюс явная инвалидация при деплое новой версии модели. При деплое вы меняете версию в префиксе ключа (ml:v1... меняется на ml:v2...). Старые ключи просто перестают запрашиваться и постепенно вымирают по TTL. Это самый безопасный путь для продакшена.
Батчинг и предвычисление: скрытые резервы CPU
Иногда лучший способ сэкономить CPU - не считать ничего в момент запроса. Если ваши данные редко меняются, рассмотрите офлайн-инференс. Вы запускаете батч-джоб ночью, который проходит по всем активным объектам (пользователям, товарам) и сохраняет их эмбеддинги или предсказания в базу данных или кеш.
Этот метод особенно эффективен для рекомендательных систем. Вместо того чтобы в реальном времени искать ближайших соседей для вектора пользователя, вы заранее считаете топ-10 рекомендаций для каждого пользователя. Днем ваш сервис делает только чтение из базы. Нагрузка на CPU падает почти до нуля, так как тяжелые матричные операции переносятся на ночные часы, когда ресурсы свободны.
Конечно, это приводит к проблеме «холодного старта». Новый пользователь не попадет в ночной батч. Для таких случаев оставляйте fallback-логику: если данных в кеше нет, считайте онлайн, но обязательно запишите результат, чтобы следующий запрос был быстрым.
Практический чек-лист перед внедрением
Прежде чем писать код, ответьте себе на эти вопросы. Они помогут избежать типичных ошибок:
- Какова стоимость инференса? Если модель считается за 10 мс, а проверка кеша в Redis - за 5 мс, вы почти ничего не экономите. Кеширование оправдано, когда время инференса превышает время доступа к кешу в 5-10 раз.
- Какова вариативность входов? Если 90% запросов уникальны, кеш будет постоянно промахиваться. Проанализируйте логи за месяц.
- Что делать с ошибкой кеша? Если Redis упал, должен ли сервис упасть вместе с ним? Нет. Реализуйте fail-open стратегию: при недоступности кеша просто идите прямо в модель, игнорируя ошибку соединения.
- Размер полезной нагрузки. Не кешируйте огромные текстовые ответы или изображения, если они занимают мегабайты. Стоимость передачи по сети и хранения может перевесить выгоду от экономии CPU.
FAQ: Частые вопросы о кешировании ML
Можно ли кешировать промежуточные слои нейросети?
Да, это называется feature caching. Если у вас глубокая сеть, первые слои могут обрабатывать сырые данные (например, токенизацию текста или resize изображений), которые меняются редко. Можно сохранить выход этих слоев в кеш и передавать в модель уже готовые тензоры. Это сильно снижает нагрузку на preprocessing-часть пайплайна, которая часто бывает узким горлышком.
Как обрабатывать случай, когда входные данные содержат timestamp?
Если время входит в промпт или фичи, хеш будет разным каждую секунду, и кеш станет бесполезным. Решение - дискретизировать время. Округляйте timestamp до часов или дней, если модель не чувствительна к секундам. Или исключите время из ключа кеша, если оно не является значимой фичей для предсказания, а используется только для логирования.
Что выбрать: Redis или Memcached для ML?
Для большинства ML-задач Redis предпочтительнее. Он поддерживает более богатые структуры данных (Hashes, Sorted Sets), что удобно для хранения метаданных предсказаний или ранжирования. Memcached проще и быстрее для простых Key-Value пар, но Redis дает больше гибкости при интеграции с Python-экосистемой (библиотеки redis-py, aioredis). Если вам нужна высокая доступность и кластеризация «из коробки», Redis также имеет преимущество.
Как тестировать эффективность кеша?
Используйте инструменты профилирования, такие как py-spy или cProfile, чтобы замерить время до и после добавления кеша. Также следите за метрикой hit rate (доля успешных попаданий в кеш) в мониторинге (Prometheus/Grafana). Если hit rate ниже 20%, скорее всего, ваши ключи слишком специфичны или TTL слишком короткий. Цель для высоконагруженных систем - hit rate выше 70-80%.
Безопасно ли использовать pickle для сериализации в Redis?
Pickle удобен, но небезопасен. Он выполняет произвольный код при десериализации. Если злоумышленник сможет записать в ваш Redis-ключ вредоносный объект, он получит выполнение кода на вашем сервере. В изолированных внутренних сетях это приемлемый компромисс ради скорости. В открытых системах используйте msgpack, protobuf или JSON с предварительной обработкой типов numpy/pandas.