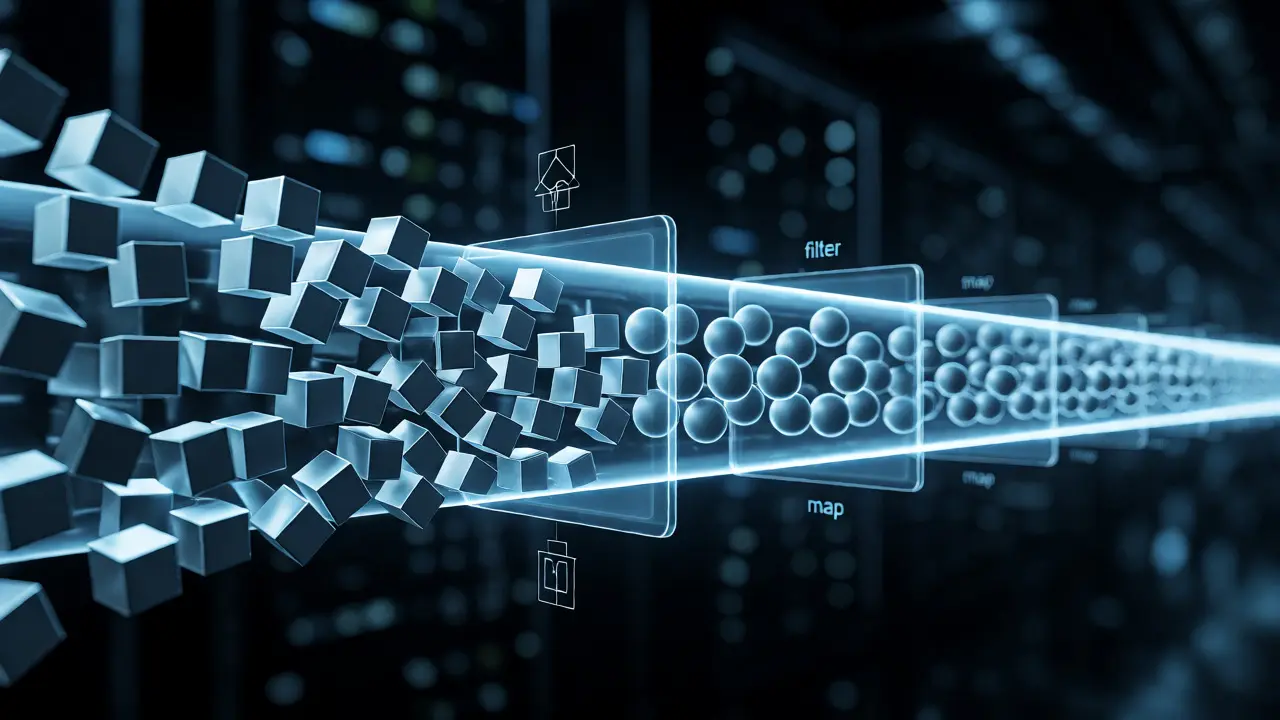
Помните те времена, когда написание цикла for для фильтрации списка было делом чести? Вы вручную создавали новый список, писали условие внутри цикла, добавляли элементы и молились, чтобы не словить NullPointerException. А потом вышла Java 8, и всё изменилось. Теперь мы пишем код, который читается как предложение: «возьми пользователей, отфильтруй активных, посчитай сумму». Звучит красиво, но есть подвох. Многие разработчики начали использовать Stream API везде подряд, даже там, где обычный цикл работает быстрее и понятнее.
В этой статье разберем, когда действительно стоит переходить на стримы, а когда лучше остаться с классическими итерациями. Мы посмотрим на реальные цифры производительности, обсудим читаемость кода и покажем, как избежать типичных ошибок при работе с потоками данных.
Что такое Stream API и зачем он нужен
Stream API - это инструмент для обработки коллекций данных декларативным способом. В отличие от императивного стиля, где вы говорите компьютеру, как делать (шаг за шагом), здесь вы описываете, что хотите получить. Это часть библиотеки java.util.stream, которая появилась в JDK 8 и стала стандартом де-факто для работы с данными.
Главная фишка стримов - ленивое выполнение. Пока вы не вызовете терминальную операцию (например, collect() или forEach()), ничего не происходит. Промежуточные операции (filter(), map()) просто собирают инструкцию. Это позволяет оптимизировать процесс выполнения «на лету».
Ключевые компоненты потока
- Источник данных: Коллекция (
List,Set), массив или входной поток ввода. - Промежуточные операции: Возвращают новый поток. Примеры:
filter,map,sorted. - Терминальные операции: Запускают обработку и возвращают результат. Примеры:
reduce,count,toList.
Когда циклы проигрывают стримам
Есть три ситуации, когда использование стримов дает реальную пользу, а не просто модный синтаксис.
1. Сложные цепочки преобразований
Представьте задачу: нужно взять список заказов, отфильтровать оплаченные, извлечь ID клиентов, удалить дубликаты и отсортировать по убыванию. С циклом это будет выглядеть так:
List<Integer> result = new ArrayList<>();
Set<Integer> seen = new HashSet<>();
for (Order order : orders) {
    if (order.isPaid()) {
        int id = order.getClientId();
        if (!seen.contains(id)) {
            seen.add(id);
            result.add(id);
        }
    }
}
collections.sort(result, Collections.reverseOrder());
Со стримами код становится прозрачным:
List<Integer> result = orders.stream()
    .filter(Order::isPaid)
    .map(Order::getClientId)
    .distinct()
    .sorted(Comparator.reverseOrder())
    .collect(Collectors.toList());
Здесь меньше шансов ошибиться с индексами или забыть добавить элемент в множество для проверки дублей. Код говорит сам за себя.
2. Параллельная обработка больших объемов данных
Если у вас многоядерный процессор и огромный список объектов, переключение одного слова превращает последовательный поток в параллельный:
list.parallelStream().map(...).reduce(...);
Java автоматически делит данные на части, обрабатывает их в разных потоках и объединяет результаты. Для задач вроде подсчета статистики по миллиону записей это может дать ускорение в 4-8 раз (в зависимости от количества ядер). Но есть нюанс: операции должны быть безопасными для конкурентного доступа.
3. Работа с примитивами через specialized streams
Обычные стримы работают с объектами-обертками (Integer, Double). Если вам нужно много считать, используйте специализированные типы:
IntStreamLongStreamDoubleStream
Они избегают автобоксинга и анбоксинга, что критично для математических вычислений.
| Критерий | Цикл for-each | Stream API |
|---|---|---|
| Читаемость простого кода | Высокая | Низкая (перегрузка) |
| Читаемость сложной логики | Низкая (громоздко) | Высокая |
| Производительность (малые списки <100) | Быстрее | Медленнее (overhead) |
| Производительность (большие списки + CPU-bound) | Стандартная | Может быть быстрее (parallel) |
| Отладка | Легко ставить брейкпоинты | Сложно трассировать стектрейс |
Ловушки производительности: когда стримы тормозят
Не верьте тем, кто говорит, что стримы всегда быстрее. На самом деле, для простых операций они часто медленнее из-за накладных расходов.
Overhead создания потока
Каждый вызов .stream() создает объект источника, затем каждый промежуточный оператор создает новый объект конвейера. Если у вас список из 5 элементов, эти объекты «весят» больше, чем полезная работа. Бенчмарки показывают, что для коллекций менее 1000 элементов простой цикл for обычно выигрывает по времени исполнения.
Проблемы с параллельными стримами
Многие думают: «Добавлю parallel() и все станет быстрее». Это миф. Параллельные стримы используют общий пул потоков ForkJoinPool.commonPool(). Если ваш код выполняет I/O операции (чтение файлов, запросы к БД), блокировка общего пула может остановить другие части приложения.
Кроме того, не все источники данных легко делятся на части. Например, LinkedList плохо подходит для параллельных стримов, потому что разбиение списка требует обхода всех элементов. Лучше всего работают ArrayList и массивы.
Side effects (побочные эффекты)
Функциональный стиль запрещает изменять внешние переменные внутри лямбд. Посмотрите на этот плохой пример:
List<String> names = new ArrayList<>();
users.stream().forEach(u -> names.add(u.getName())); // Плохо!
Это антипаттерн. Используйте collect(Collectors.toList()). Если вы меняете состояние внешнего объекта внутри forEach или peek, вы ломаете контракт функционального программирования, и код становится непредсказуемым, особенно в параллельном режиме.
Практические рекомендации: чек-лист выбора
Как принять решение прямо во время кодинга? Ответьте на эти вопросы:
- Нужна ли вам параллельность? Если да и данные большие (>10k элементов) - берите стримы.
- Сложная ли цепочка операций? Если у вас более двух фильтров или маппингов - стримы сделают код чище.
- Работаете ли вы с примитивами? Используйте
IntStream/DoubleStreamвместоStream<Integer>. - Важна ли максимальная скорость на малых данных? Оставьте обычный цикл.
- Нужен ли доступ к индексам? Стримы скрывают индексы. Если нужна позиция элемента, проще использовать цикл.
Альтернатива: Vavr.io
Иногда стандартного Stream API не хватает. Библиотека Vavr предоставляет более богатый функциональный инструментарий для Java. Она позволяет писать более лаконичный код и лучше работать с ошибками через тип Try. Однако внедрение сторонней библиотеки ради пары методов может быть избыточным.
Пример из жизни: обработка логов
Допустим, нам нужно найти топ-5 самых частых IP-адресов в логах сервера. Логи приходят как List<LogEntry>.
Вариант с циклом:
Map<String, Integer> counts = new HashMap<>();
for (LogEntry entry : logs) {
    String ip = entry.getIp();
    counts.put(ip, counts.getOrDefault(ip, 0) + 1);
}
// Затем сортировка и выбор топ-5... много кода.
Вариант со стримами:
Map<String, Long> topIps = logs.stream()
    .collect(Collectors.groupingBy(LogEntry::getIp, Collectors.counting()))
    .entrySet().stream()
    .sorted(Map.Entry.<String, Long>comparingByValue().reversed())
    .limit(5)
    .collect(Collectors.toMap(
        Map.Entry::getKey,
        Map.Entry::getValue,
        (e1, e2) -> e1,
        LinkedHashMap::new
    ));
Хотя второй вариант длиннее визуально, он разделен на логические этапы: группировка, сортировка, ограничение. Такой код легче поддерживать, если завтра потребуется изменить условие фильтрации.
Заключение
Stream API - это мощный инструмент, но не серебряная пуля. Он идеален для декларативной обработки данных, сложных трансформаций и распараллеливания. Но он не заменит циклы там, где важна предельная эффективность на малых объемах или нужен прямой контроль над итерацией.
Пишите код так, чтобы его понимали другие люди. Если стрим делает код короче и понятнее - используйте его. Если он запутывает - возвращайтесь к циклам. Баланс между производительностью и читаемостью - вот настоящий профессионализм.
Можно ли использовать Stream API в Android?
Да, начиная с Android API level 24 (Android 7.0). Для старых версий нужно включать desugaring в настройках Gradle проекта, иначе компилятор выдаст ошибку.
Что быстрее: parallelStream() или обычный stream()?
Для малых списков (до нескольких тысяч элементов) обычный стрим быстрее из-за затрат на создание потоков и координацию. ParallelStream выигрывает только на больших объемах данных и при наличии свободных ядер процессора.
Можно ли повторно использовать один и тот же Stream?
Нет. Stream является одноразовым объектом. После вызова терминальной операции (например, collect или forEach) поток считается закрытым. Повторное использование выбросит IllegalStateException. Нужно создавать новый поток заново.
Как отлаживать сложные цепочки стримов?
Используйте метод peek() для вывода промежуточных результатов в консоль. Также можно временно разбить длинную цепочку на несколько переменных, чтобы поставить точки останова в IDE между этапами обработки.
Стоит ли учить Kotlin вместо Java для работы с коллекциями?
Kotlin имеет встроенные расширения для коллекций, которые похожи на стримы, но работают без overhead объектов Stream. Если проект новый, Kotlin часто предпочтительнее. Если легаси на Java - Stream API достаточно хорош.