Вы когда-нибудь чувствовали себя обманутым, когда добавляли потоки в свой скрипт для ускорения работы с API, а время выполнения только росло? Это классическая ловушка GIL (Global Interpreter Lock - механизм в CPython, который блокирует параллельное выполнение байткода Python несколькими потоками). Для I/O-операций потоки работают отлично, но как только вы сталкиваетесь с тысячами одновременных соединений, они начинают задыхаться. Именно здесь на сцену выходит asyncio (библиотека для написания однопоточного кода с использованием событийной модели и неблокирующего ввода-вывода).
Но стоит ли переписывать весь проект ради этого? Не всегда. Асинхронность требует полного контроля над стеком библиотек и меняет архитектуру приложения. Если вы выберете не тот инструмент, получите не производительность, а головную боль из-за блокирующих вызовов внутри цикла событий. Давайте разберемся, где реально стоит переходить на asyncio, а где лучше остаться на threading.
Ключевые выводы
- I/O-bound задачи: Если программа ждет ответа от сети или диска,
asyncioдает огромный выигрыш за счет низкой стоимости контекстного переключения. - CPU-bound задачи: Потоки и
asyncioбесполезны из-за GIL. Используйтеmultiprocessing. - Экосистема: Переход на асинхронность невозможен, если ваши критические библиотеки (например, старые версии
requests) блокируют поток. - Сложность поддержки: Смешивание синхронного и асинхронного кода создает «грязные» границы, которые трудно отлаживать.
Почему потоки иногда проигрывают
Представьте, что вам нужно скачать 1000 файлов. С threading (модуль стандартной библиотеки Python для создания и управления потоками выполнения) вы создадите пул из 50-100 потоков. Каждый поток занимает около 8 МБ памяти стека. При 1000 одновременных операций память взлетит до гигабайтов, а операционная система будет тратить ресурсы на переключение между ними (context switching). Это дорого.
asyncio работает иначе. Он использует один поток и одну корутину (coroutine) для каждой задачи. Стоимость создания одной корутины измеряется килобайтами, а не мегабайтами. Вы можете держать открытыми десятки тысяч соединений одновременно без перегрузки системы. Но есть нюанс: этот подход работает только если код действительно неблокирующий. Одна случайная функция time.sleep() или запрос через синхронную библиотеку остановит весь цикл событий, превратив преимущество в катастрофу.
Когда выбирать asyncio вместо threading
Выбор зависит от типа нагрузки. Вот простая эвристика, которую используют инженеры при проектировании сервисов:
| Характеристика | Threading | Asyncio | Multiprocessing |
|---|---|---|---|
| Основное назначение | I/O-bound (сетевые запросы, файлы) | I/O-bound с высокой конкуренцией | CPU-bound (вычисления) |
| Влияние GIL | Блокирует CPU-параллелизм, но пропускает I/O | Не влияет (один поток) | Обходит GIL полностью |
| Стоимость создания единицы | Высокая (~8 МБ RAM) | Низкая (~KBs RAM) | Очень высокая (копия процесса) |
| Сложность кода | Средняя (гонки данных, локи) | Высокая (propaganda of async) | Низкая (изоляция процессов) |
| Поддержка библиотек | Широкая (все синхронные либы) | Ограниченная (нужны async-версии) | Широкая (но serialization data) |
Если вы пишете веб-сервер на FastAPI (современный высокопроизводительный веб-фреймворк для Python, основанный на стандарте ASGI) или микросервис, который общается с десятками других сервисов, asyncio обязателен. Он позволяет обрабатывать тысячи запросов в секунду на одном ядре процессора. В то же время, если ваш скрипт просто скачивает несколько больших архивов по FTP, разница будет минимальной, а возни с настройкой event loop больше.
Ловушки миграции: «Contagious Async»
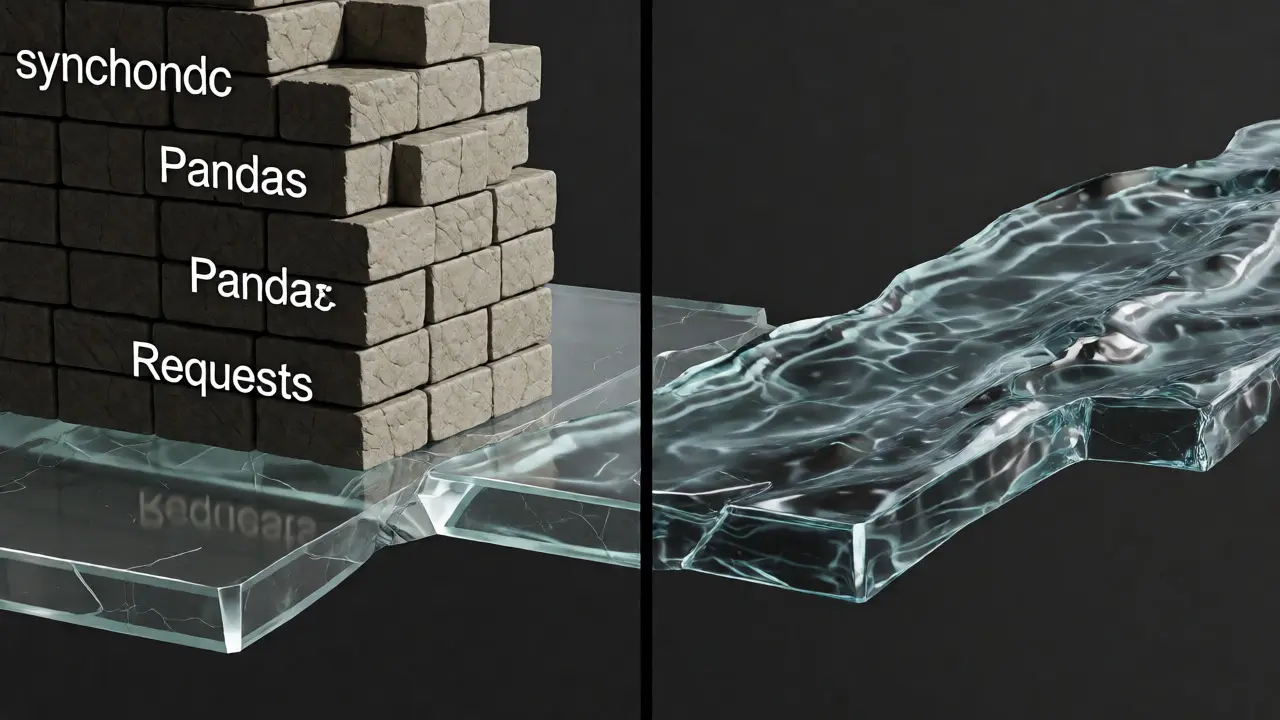
Главная проблема перехода - заразность асинхронности. Как только одна функция становится async def, все функции, которые ее вызывают, тоже должны стать асинхронными или использовать специальные обертки. Это называется «propaganda of async». Вы не можете просто взять старый модуль обработки данных и вызвать его из асинхронного контекста, если он содержит блокирующие операции.
Например, библиотека Pandas (популярная библиотека для анализа данных в Python) является синхронной. Если вы попытаетесь выполнить тяжелый анализ DataFrame внутри асинхронного обработчика, вы заблокируете весь сервер для всех остальных пользователей. Решение - запускать такие задачи в отдельном пуле потоков через loop.run_in_executor(), но это усложняет логику.
Другая частая ошибка - использование синхронных HTTP-клиентов вроде requests внутри asyncio. Они блокируют поток на время ожидания ответа. Вместо них нужно использовать aiohttp (асинхронный HTTP клиент и сервер для Python) или httpx. Проверьте свои зависимости перед миграцией. Если ключевая библиотека не имеет async-аналога, возможно, стоит остаться на потоках.
Практический пример: изменение архитектуры
Давайте посмотрим, как меняется код. Допустим, нам нужно получить данные с трех эндпоинтов.
Вариант с Threading:
import threading
import requests

def fetch_data(url):
    response = requests.get(url)
    return response.json()

urls = ['url1', 'url2', 'url3']
threads = []
results = [None] * len(urls)

def worker(index, url):
    results[index] = fetch_data(url)

for i, url in enumerate(urls):
    t = threading.Thread(target=worker, args=(i, url))
    threads.append(t)
    t.start()

for t in threads:
    t.join()
Здесь мы явно управляем жизненным циклом потоков. Код громоздкий, легко ошибиться с индексами или блокировками.
Вариант с Asyncio:
import asyncio
import aiohttp

async def fetch_data(session, url):
    async with session.get(url) as response:
        return await response.json()

async def main():
    urls = ['url1', 'url2', 'url3']
    async with aiohttp.ClientSession() as session:
        tasks = [fetch_data(session, url) for url in urls]
        results = await asyncio.gather(*tasks)
    return results

# Запуск цикла событий
asyncio.run(main())
Код стал чище и декларативнее. asyncio.gather запускает все запросы параллельно и ждет завершения всех. Обратите внимание: мы передаем одну сессию всем задачам, что позволяет переиспользовать соединения (connection pooling), чего сложно достичь с простым пулом потоков без дополнительных библиотек.
Производительность: цифры и факты
В реальных бенчмарках на задачах с высоким I/O latency (например, обращение к внешнему API с задержкой 200 мс) разница колоссальна. Сервер на Flask (синхронный, многопоточный) может обрабатывать ~1000 RPS (запросов в секунду) на определенном железе. Тот же логически эквивалентный сервис на FastAPI (асинхронный) легко берет 5000-10000 RPS. Это связано с тем, что потоки тратят время на создание/уничтожение и переключение контекста, тогда как корутины просто «спят» в очереди событий, потребляя минимум ресурсов.
Однако, если ваша задача - обработка изображений или парсинг HTML с помощью BeautifulSoup (который CPU-intensive и синхронный), перевод на asyncio ничего не даст. Вы лишь добавите накладные расходы на управление event loop. В таких случаях правильнее использовать concurrent.futures.ProcessPoolExecutor.
Можно ли смешивать asyncio и threading в одном проекте?
Да, и это часто необходимо. Например, вы можете запустить асинхронный веб-сервер, но использовать пул потоков для выполнения старых синхронных задач (например, генерации PDF или работы с легаси-базой данных). Главное правило: никогда не блокируйте event loop. Все синхронные блокирующие вызовы должны выполняться в отдельном executor'е через `loop.run_in_executor`.
Что такое "blocking call" в контексте asyncio?
Blocking call - это функция, которая останавливает выполнение потока до завершения операции. В асинхронном коде это смертельно, так как блокирует всю программу. Примеры: `time.sleep()`, `requests.get()`, сложные математические вычисления. Вместо них нужно использовать `await asyncio.sleep()`, `aiohttp` или переносить вычисления в потоки/процессы.
Заменит ли asyncio потоки полностью в будущем?
Нет. У каждого инструмента своя ниша. PEP 703 (Free-threaded CPython) пытается убрать GIL, что может сделать потоки более привлекательными для CPU-задач, но asyncio останется стандартом де-факто для сетевой I/O-конкурентности благодаря своей эффективности и простоте модели программирования.
Как отлаживать зависания в asyncio?
Частая причина зависаний - отсутствие `await` перед вызовом корутины или блокирующий вызов внутри нее. Используйте флаг `-X dev` при запуске Python для включения debug mode, который покажет предупреждения о медленных callback'ах. Также полезно логировать время жизни задач с помощью `asyncio.timeout()` (в новых версиях Python).
Какие библиотеки обязательны для старта с asyncio?
Для сети - `aiohttp` или `httpx`. Для БД - `asyncpg` (PostgreSQL), `aiomysql` или `motor` (MongoDB). Для фреймворков - `FastAPI` или `Sanic`. Избегайте использования синхронных клиентов (`psycopg2`, `requests`) внутри асинхронного кода без обертки в executor.