Знаете это чувство, когда база данных начинает стонать от нагрузки, а каждый запрос к серверу превращается в вечность? Это классическая боль любого Python-разработчика, который вырос из пет-проекта на одном пользователе до приложения с реальным трафиком. Вы написали идеальный код, оптимизировали SQL-запросы, но всё равно упираетесь в потолок производительности. Решение часто лежит на поверхности и называется кэширование. И если вы слышали про Redis, но думали, что это «магия для сеньоров», то эта статья перевернет ваше представление.
Redis - это не просто хранилище ключ-значение. Это инструмент, который может спасти ваш проект от падения под нагрузкой за считанные часы настройки. Давайте разберемся, как внедрить его в бэкенд на Python без головной боли, даже если вы раньше видели Redis только в скриншотах из вакансий.
Почему базы данных не справляются (и почему это нормально)
Давайте будем честны: реляционные базы данных вроде PostgreSQL или MySQL созданы для надежности и целостности данных, а не для скорости чтения одинаковых строк тысячи раз в секунду. Когда пользователь открывает главную страницу вашего интернет-магазина, ему нужны данные о товарах. Эти данные меняются редко. Но если у вас 1000 пользователей одновременно, ваша база выполняет 1000 одинаковых запросов к одной и той же таблице товаров.
Это расточительно. Процессор тратит ресурсы на поиск тех же самых строк снова и снова. Здесь на сцену выходит оперативная память. Кэширование по сути означает: «Сохраните результат этого дорогого запроса где-то очень быстро доступном месте, чтобы следующий такой же запрос забрал данные оттуда, не трогая базу».
| Источник | Время доступа (примерное) | Назначение |
|---|---|---|
| Регистры CPU | < 1 нс | Вычисления процессора |
| L1/L2 Cache CPU | ~1-10 нс | Быстрые данные для ядра |
| RAM (Оперативная память) | ~50-100 нс | Хранение активных процессов |
| SSD Disk | ~100 мкс - 1 мс | Хранение файлов и БД |
| Network Request | ~10-100 мс | Внешние API |
Как видите, разница между обращением к SSD (где живет ваша база) и RAM (где живет Redis) колоссальна. Redis хранит данные в памяти, поэтому он читает их в миллионы раз быстрее диска.
Что такое Redis простыми словами
Redis (Remote Dictionary Server) - это открытое программное обеспечение, которое работает как хранилище структур данных в памяти. В отличие от обычного словаря в Python, Redis:
- Работает как отдельный сервис (процесс), к которому можно подключаться по сети.
- Поддерживает сложные структуры данных: строки, списки, множества, хэши.
- Умеет автоматически удалять данные через определенное время (TTL).
Для начинающего разработчика важно понять одну вещь: Redis не заменяет вашу основную базу данных. Он ее дополняет. Представьте, что база данных - это архив в подвале с толстыми папками, а Redis - это стол секретаря на ресепшене, где лежат самые важные документы, которые нужны прямо сейчас.
Первые шаги: Установка и подключение из Python
Не нужно сразу ставить Docker Compose с десятью контейнерами. Для начала достаточно запустить один инстанс Redis локально. Если у вас Linux/macOS, команда brew install redis или использование Docker docker run -d --name redis-stack -p 6379:6379 redis/redis-stack-server:latest сделает все за секунды.
Теперь подключимся из Python. Самая популярная библиотека для работы с Redis в экосистеме Python - это redis-py. Она легкая, синхронная и отлично подходит для большинства задач.
pip install redisПример простого подключения:
import redis

# Подключение к локальному Redis
r = redis.Redis(host='localhost', port=6379, db=0)

# Сохранение значения
r.set('user:101:name', 'Иван')

# Чтение значения
name = r.get('user:101:name')
print(name.decode('utf-8')) # Выведет: Иван
Обратите внимание на метод .decode(). Redis возвращает байты, так как он не знает, какая кодировка вам нужна. В Python 3 это частая ловушка для новичков.
Стратегия Cache-Aside: Самый безопасный паттерн
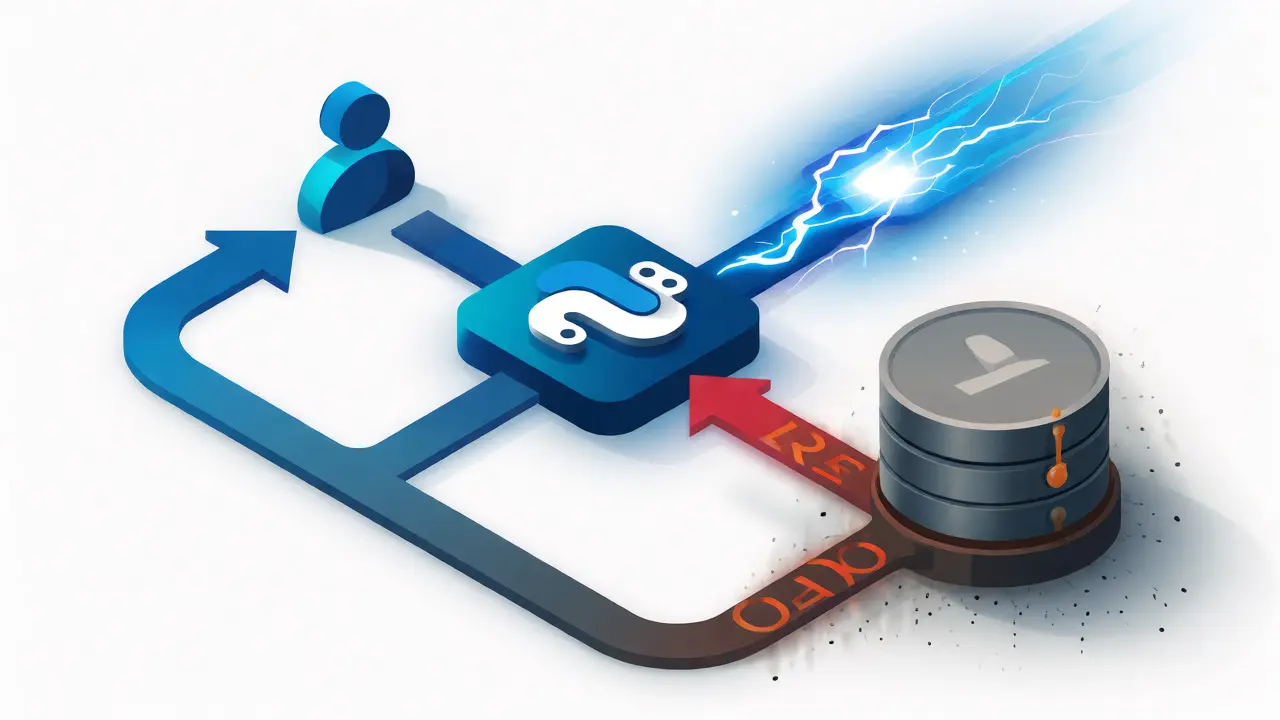
Как именно использовать кэш? Не пытайтесь кэшировать всё подряд. Начните с паттерна Cache-Aside (или «load-through»). Логика проста:
- Запрос приходит в приложение.
- Приложение проверяет, есть ли данные в Redis.
- Если есть (cache hit) - возвращаем их пользователю. База не трогается.
- Если нет (cache miss) - делаем запрос к базе данных.
- Сохраняем результат из базы в Redis с временем жизни (TTL).
- Возвращаем данные пользователю.
Этот подход хорош тем, что он устойчив к ошибкам. Если Redis упадет, ваше приложение просто перестанет находить данные в кэше и будет обращаться напрямую к базе. Оно станет медленнее, но не сломается полностью.
Интеграция с фреймворками: Django vs FastAPI
В зависимости от того, какой фреймворк вы используете, интеграция будет немного отличаться.
Django
В Django поддержка кэша встроена в систему settings. Вам нужно лишь указать backend в файле settings.py:
CACHES = {
    "default": {
        "BACKEND": "django.core.cache.backends.redis.RedisCache",
        "LOCATION": "redis://127.0.0.1:6379",
    }
}
После этого вы можете использовать декораторы @cache_page для целых страниц или функции cache.get()/cache.set() внутри логики. Это самый быстрый способ получить эффект, особенно для контентных сайтов.
FastAPI
В FastAPI всё более ручное, но и более гибкое. Поскольку FastAPI асинхронный, лучше использовать библиотеку redis.asyncio.
from fastapi import FastAPI
import redis.asyncio as redis

app = FastAPI()
r = redis.from_url("redis://localhost")

@app.get("/item/{id}")
async def get_item(id: int):
    cached_data = await r.get(f"item:{id}")
    if cached_data:
        return cached_data.decode()

    # Заглушка для запроса к БД
    data_from_db = f"Data for item {id}"
    await r.setex(f"item:{id}", 60, data_from_db) # TTL 60 секунд
    return data_from_db
Здесь важно помнить про конкурентность. Если два запроса придут одновременно при пустом кэше, оба полезут в базу. Для высоких нагрузок это может быть проблемой, но для старта это приемлемо.
Частые ошибки новичков
Казалось бы, что тут сложного? Поставил кэш - стал быстрее. Но есть нюансы, которые могут превратить кэширование в рассадник багов.
1. Устаревшие данные (Stale Data). Вы обновили профиль пользователя в базе, но забыли удалить старый ключ из Redis. Пользователь видит старые данные еще 5 минут (пока не истечет TTL). Всегда пишите логику инвалидации кэша при обновлении данных. Правило простое: Update DB -> Delete Key from Redis.
2. Слишком большой TTL. Не ставьте время жизни кэша в сутки, если данные важны. Лучше поставить 5-10 минут и иметь возможность обновить вручную. Чем короче TTL, тем меньше риск видеть устаревшую информацию.
3. Кэширование всего подряд. Не кэшируйте уникальные запросы, которые выполняются один раз. Кэш имеет смысл только тогда, когда данные запрашиваются повторно. Кэширование редких запросов только занимает память Redis впустую.
4. Отсутствие обработки ошибок подключения. Что будет, если сеть моргнет и Redis станет недоступен? Ваш код должен падать грациозно. Оборачивайте вызовы Redis в try-except блоки. Если кэш недоступен, логируйте ошибку и идите в базу данных.
Когда переходить на продвинутый уровень?
Redis умеет гораздо больше, чем просто хранить JSON-строки. Когда вы освоите базовое кэширование, посмотрите в сторону этих возможностей:
- Сессии: Хранение сессий пользователей в Redis вместо куки или базы данных. Это позволяет легко масштабировать приложение на несколько серверов.
- Rate Limiting: Ограничение количества запросов с одного IP. Redis идеально подходит для подсчета запросов благодаря атомарным операциям
INCR. - Pub/Sub: Простая система сообщений для уведомления микросервисов об изменениях.
Но не гонитесь за всем сразу. Начните с малого. Внедрите кэширование для самой горячей страницы вашего сайта. Измерьте время ответа до и после. Вы удивитесь, насколько сильно изменится отзывчивость интерфейса.
Кэширование - это не серебряная пуля, которая решит все проблемы производительности. Но это первый и самый эффективный шаг, который должен сделать каждый Python-разработчик, стремящийся создать быстрый и надежный бэкенд. Попробуйте добавить Redis в свой текущий проект сегодня вечером. Скорее всего, вы пожалеете только об одном: что не сделали этого раньше.
Нужен ли Redis, если у меня маленький проект?
Для совсем маленьких проектов с десятком пользователей Redis может быть избыточным. Однако, если вы планируете рост, настройка Redis с самого начала сэкономит время в будущем. Кроме того, Redis полезен даже на малых проектах для хранения сессий или временных данных, которые не хочется тащить в реляционную базу.
Что делать, если Redis переполнится памятью?
Redis позволяет настроить политику вытеснения (eviction policy). Например, политика allkeys-lru удаляет наименее недавно используемые ключи, когда память заканчивается. Это гарантирует, что сервис продолжит работать, хотя часть кэша будет потеряна. Важно правильно выбрать политику в конфигурации redis.conf.
Можно ли использовать Redis как основную базу данных?
Теоретически да, но на практике редко. Redis поддерживает персистентность (сохранение на диск), но она менее надежна и функциональна, чем у специализированных СУБД. Также Redis ограничен объемом оперативной памяти сервера. Обычно его используют как слой кэша или для специфических задач (рейтинги, очереди), оставляя основную ответственность за хранение данных за PostgreSQL или MongoDB.
Как сериализовать сложные объекты Python в Redis?
Redis хранит только строки и числа. Для сложных объектов (словари, списки, модели ORM) нужно использовать сериализацию. Самые популярные варианты: json.dumps/json.loads (медленно, но читаемо человеком) или pickle (быстро, но небезопасно при загрузке сторонних данных). Для высоконагруженных систем часто используют msgpack или protobuf.
Чем отличается redis-py от aioredis?
Библиотека redis-py является синхронной и блокирует поток выполнения во время сетевых операций. Это нормально для традиционных приложений (Flask, стандартный Django). Библиотека aioredis (теперь интегрирована в redis-py как redis.asyncio) предназначена для асинхронных приложений (FastAPI, Sanic, asyncio-код), позволяя обрабатывать другие задачи, пока ожидает ответ от Redis.