Вы когда-нибудь чувствовали, что ваш сервер задыхается от повторных запросов на одни и те же данные? Это классическая проблема. Пользователь открывает профиль, обновляет страницу, переходит в другой раздел и возвращается обратно. Ваш бэкенд снова и снова лезет в базу данных, выполняет тяжелые джойны и возвращает тот же самый JSON. Результат? Высокая нагрузка на CPU, медленные ответы для клиента и счета за облачную инфраструктуру, которые растут быстрее, чем ваша зарплата.
Кэширование ответов API - это не просто оптимизация «на потом». Это фундаментальный механизм, который отделяет масштабируемые системы от тех, что падают под нагрузкой в пятницу вечером. Но кэшировать всё подряд нельзя. Если вы вернете устаревшие данные о балансе пользователя или списке заказов, вы получите баги, которые сложнее найти, чем исправить. Здесь на сцену выходит TTL (Time To Live) - время жизни кэша. Как выбрать правильный TTL? Где хранить кэш? И как не сойти с ума от инвалидации? Разберем по полочкам, без лишней воды.
Зачем вообще кэшировать ответы API
Давайте честно: чтение из базы данных дорогое. Даже если у вас быстрый SSD и настроенные индексы, каждый SQL-запрос требует ресурсов процессора, памяти и дискового ввода-вывода. А теперь представьте, что этот запрос выполняется 1000 раз в секунду для одного и того же товара в интернет-магазине. Вы тратите ресурсы впустую.
Кэширование работает по принципу: «сохрани результат один раз, отдавай многократно». Когда клиент делает запрос, система сначала проверяет кэш. Если данные там есть и они актуальны, ответ отправляется мгновенно, минуя базу данных. Это снижает нагрузку на СУБД и сокращает время ответа (latency).
- Снижение нагрузки на базу данных: Меньше запросов к Postgres или MySQL означает меньше блокировок и более стабильную работу при пиковых нагрузках.
- Ускорение отклика: Чтение из оперативной памяти (например, через Redis) происходит в микросекунды, тогда как сложный SQL-запрос может занимать миллисекунды или даже секунды.
- Экономия денег: В облачных средах (AWS, Yandex Cloud) вы платите за использование ресурсов. Меньше вычислений - меньше чек.
Стратегии кэширования: где ставить заслон
Не существует одной правильной стратегии для всех случаев. Выбор зависит от типа данных и требований бизнеса. Вот основные подходы, которые используют инженеры.
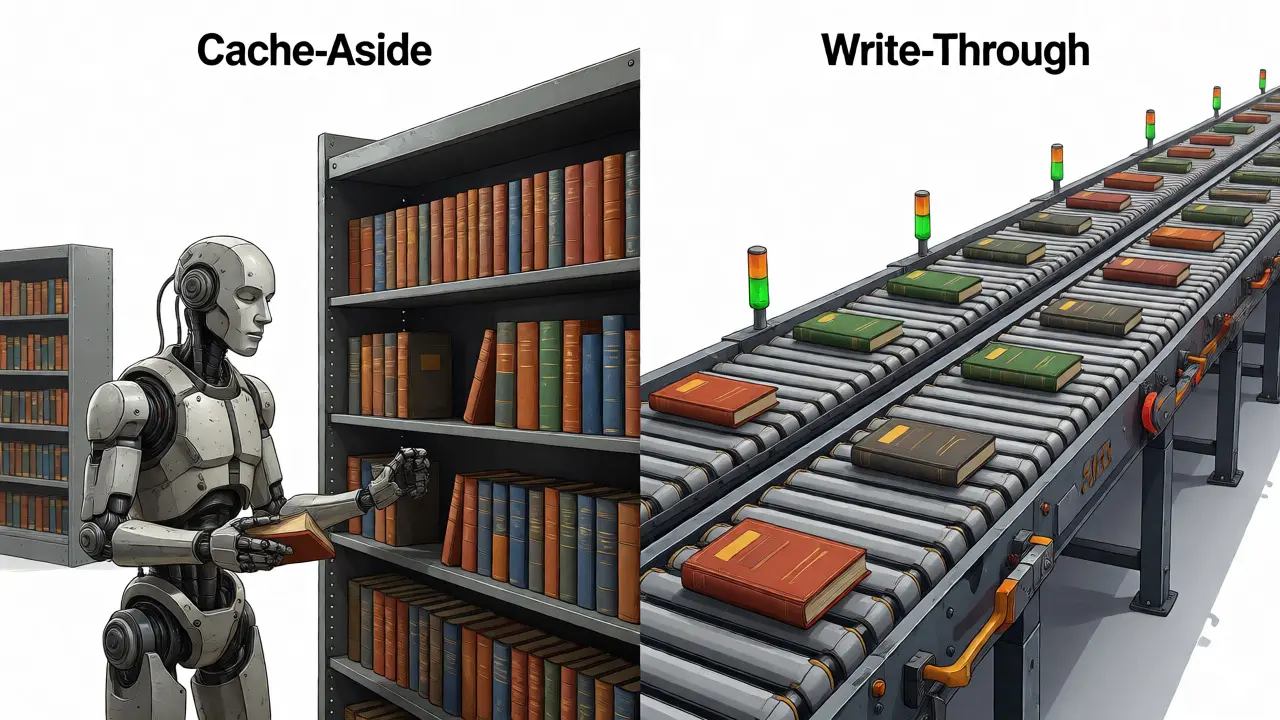
Cache-Aside (Ленивая загрузка)
Это самый популярный паттерн. Приложение само управляет кэшем. Логика проста: при запросе данных приложение сначала смотрит в кэш. Если данных нет (cache miss), оно читает их из базы, пишет в кэш и возвращает клиенту. При обновлении данных приложение удаляет запись из кэша.
Плюс этого подхода в простоте реализации. Минус - если кэш упадет, база данных получит шквал запросов одновременно, так как все потоки пойдут читать данные из БД. Это называется «проблема громовой стаи» (thundering herd).
Write-Through
Здесь кэш всегда синхронизирован с базой данных. Все записи идут через кэш-менеджер, который пишет данные и в кэш, и в базу одновременно. Клиент получает подтверждение только после успешной записи в оба места.
Такой подход гарантирует консистентность данных, но замедляет операции записи. Идеально подходит для систем, где критична точность данных в реальном времени, например, финансовые транзакции.
Write-Behind (Write-Back)
Приложение пишет данные только в кэш и сразу отвечает клиенту. Кэш асинхронно, пакетно, обновляет базу данных позже. Это дает максимальную скорость записи, но несет риск потери данных, если сервер кэша упадет до синхронизации с БД.
TTL: искусство балансировки между свежестью и скоростью
TTL (Time To Live) - это время, в течение которого кэшированные данные считаются валидными. После истечения TTL запись удаляется из кэша, и следующий запрос пойдет в базу данных. Выбор правильного значения TTL - это компромисс.
| Тип данных | Рекомендуемый TTL | Обоснование |
|---|---|---|
| Статический контент (описание товара) | 1-24 часа | Тексты меняются редко. Можно позволить себе долгий кэш. |
| Динамические списки (лента новостей) | 1-5 минут | Пользователи ожидают видеть свежие посты, но не каждую секунду. |
| Данные профиля пользователя | 5-15 минут | Имя или аватарка меняются нечасто, но изменения должны отражаться быстро. |
| Остатки на складе | 10-60 секунд | Риск продать товар, которого нет, выше, чем риск показать чуть устаревшее число. |
| Цены акций | 0 (или 1-2 сек) | Финансовые данные требуют максимальной актуальности. Часто не кэшируются вовсе. |
Как определить TTL? Задайте себе вопрос: «Какие данные я могу показать пользователю, зная, что они были получены N минут назад?» Для блога это может быть час. Для биржи криптовалют - доли секунды.
HTTP-заголовки: контроль кэша на стороне клиента
Не стоит забывать про браузеры и CDN (Content Delivery Network). Вы можете управлять кэшированием прямо через HTTP-заголовки ответа API. Это позволяет избежать лишних запросов к вашему серверу еще до того, как они до него дойдут.
- Cache-Control: Самый важный заголовок. Например,
Cache-Control: max-age=3600говорит браузеру: «Храни этот ответ в кэше в течение 3600 секунд, не спрашивай меня ни о чем». Илиno-cache, чтобы требовать проверки актуальности перед каждым использованием. - ETag: Уникальный идентификатор версии ресурса (обычно хеш содержимого). Браузер сохраняет его и при следующем запросе отправляет заголовок
If-None-Match. Если ETag совпадает, сервер отвечает кодом304 Not Modifiedбез тела ответа. Экономия трафика! - Last-Modified: Дата последнего изменения ресурса. Работает аналогично ETag, но менее точно, так как зависит от часовых поясов и формата даты.
Комбинация этих заголовков позволяет создать эффективную двухуровневую систему кэширования: быстрый локальный кэш браузера и распределенный кэш на сервере.
Инструменты: чем кэшировать?
Выбор технологии хранения кэша зависит от объема данных и требований к надежности.
| Инструмент | Тип хранения | Преимущества | Недостатки |
|---|---|---|---|
| Redis | RAM (In-memory) | Очень быстрый, поддерживает сложные структуры данных, кластеризация. | Дорогой объем памяти, требует настройки персистентности. |
| Memcached | RAM (In-memory) | Простота, высокая производительность для простых ключ-значение пар. | Нет сложных структур, нет встроенной репликации. |
| CDN (Cloudflare, Fastly) | Edge nodes | Кэширует статические ответы ближе к пользователю, снижает latency глобально. | Сложнее настроить для динамического контента, стоимость. |
| Локальный кэш (Node.js LRU-Cache) | RAM процесса | Нулевая сетевая задержка, очень быстр. | Не разделяется между экземплярами приложения, занимает память процесса. |
Для большинства веб-приложений связка Redis + CDN является золотым стандартом. Redis справляется с динамическими данными внутри инфраструктуры, а CDN берет на себя статику и часто запрашиваемые GET-запросы.
Подводные камни: инвалидация и проблемы кэша
Есть две сложные вещи в компьютерных науках: naming things и cache invalidation. Неудачная стратегия инвалидации приводит к тому, что пользователи видят старые данные или, наоборот, получают ошибки из-за отсутствующих ключей.
Проблема громовой стаи (Thundering Herd)
Представьте: TTL истек для популярного поста. Тысячи пользователей одновременно обращаются к нему. Все они находят пустой кэш и кидают запросы в базу данных. База ложится. Решение: использовать mutex-блокировки (lock) при заполнении кэша или продлевать TTL фоновыми задачами (refresh-ahead).
Каскадный отказ
Если сервис кэширования недоступен, весь трафик обрушивается на базу данных. Важно иметь fallback-логику: если Redis упал, приложение должно работать, пусть и медленнее, читая напрямую из БД, а не падать с ошибкой соединения.
Несогласованность данных
В распределенных системах запись в базу и удаление из кэша могут происходить с задержкой. Используйте паттерны вроде «delete then write» или стримы событий (Kafka/RabbitMQ) для гарантированной инвалидации кэша после изменений в базе.
Практические советы по внедрению
Не пытайтесь кэшировать всё с первого дня. Начните с анализа логов. Найдите эндпоинты с наибольшим количеством повторных одинаковых запросов. Обычно это 20% эндпоинтов, генерирующих 80% нагрузки.
- Измеряйте: Используйте APM-системы (Datadog, Prometheus) для отслеживания hit ratio (процент попаданий в кэш). Целевой показатель - выше 80%.
- Серализуйте эффективно: JSON удобен, но занимает много места. Рассмотрите MessagePack или Protocol Buffers для экономии памяти в Redis.
- Разделяйте кэш: Не храните мелкие быстрые данные и большие тяжелые объекты в одном пуле. Используйте разные инстансы Redis или префиксы ключей.
- Будьте осторожны с персонализацией: Если ответ зависит от ID пользователя, ключ кэша должен включать этот ID. Иначе пользователь А увидит данные пользователя Б.
Что такое Cache Hit Ratio и почему он важен?
Cache Hit Ratio - это процент запросов, которые успешно обслужены из кэша, без обращения к базе данных. Формула простая: (Количество попаданий в кэш / Общее количество запросов) * 100%. Высокий коэффициент (выше 90%) означает, что ваша система эффективна и база данных разгружена. Низкий коэффициент сигнализирует о неправильной настройке TTL или ключей кэша.
Можно ли кэшировать POST-запросы?
По стандарту HTTP, методы POST не являются идемпотентными и обычно не кэшируются. Однако, если ваш POST-запрос фактически выполняет операцию чтения (что иногда случается в сложных GraphQL или RPC интерфейсах), вы можете реализовать кэширование на уровне приложения. Но будьте осторожны: кэширование операций записи может привести к потере данных или несогласованности, если не использовать сложные стратегии Write-Through или Write-Behind.
Чем отличается TTL от Expires?
TTL (Time To Live) - это относительное время жизни, измеряемое в секундах с момента создания записи (например, «жить 300 секунд»). Заголовок Expires указывает абсолютное время (дату и время), когда ресурс станет невалидным. В современных системах чаще используют Cache-Control с директивой max-age (аналог TTL), так как она не зависит от рассинхронизации часов между клиентом и сервером, которая может искажать значение Expires.
Что делать, если данные изменились, а TTL еще не истек?
Вам нужно вручную инвалидировать кэш. Это можно сделать двумя способами: удалить конкретный ключ из кэша сразу после обновления данных в базе (паттерн Cache-Aside) или изменить версию ключа (версионирование). Например, вместо ключа user:123 использовать user:123:v2. Это позволяет мгновенно сбросить кэш для всех связанных объектов, просто увеличив счетчик версии.
Нужен ли отдельный сервер для Redis?
На этапе прототипирования или небольшого проекта Redis можно запустить на том же сервере, что и приложение. Однако для продакшена настоятельно рекомендуется выделять отдельный инстанс или кластер. Это изолирует нагрузку: если ваше приложение потребит всю оперативную память, Redis не упадет вместе с ним, и наоборот. Кроме того, отдельный сервер позволяет масштабировать кэш независимо от логики приложения.