Вы только вышли на первую работу, и вдруг вам прилетает тикет: «На проде всё сломалось». Сердце уходит в пятки. Вы открываете код, смотрите на логи и понимаете, что не знаете, с чего начать. Знакомо? Паника - нормальная реакция, но она мешает думать ясно. На самом деле, разбор багов в production-среде - это не магия, а скучный, предсказуемый процесс. Если у вас есть правильный алгоритм действий, вы справитесь быстрее, чем опытный коллега, который просто «чувствует» систему.
Главная ошибка новичков - сразу лезть в код и пытаться исправить то, что они увидели первым делом. Это как менять шину на машине, даже не проверив, проколото ли колесо или проблема в двигателе. Давайте разберем, как подходить к проблеме системно, чтобы не навредить и найти корень зла за разумное время.
Почему прод отличается от локалки?
Прежде чем копаться в коде, нужно понять контекст. Production-среда (окружение, где работает реальное приложение для конечных пользователей) кардинально отличается от вашего ноутбука. Там нет доступа к базе данных напрямую через GUI, там другие настройки переменных окружения, там живут реальные данные, которые нельзя трогать руками без бэкапа.
Когда вы воспроизводите баг локально, вы контролируете входные данные. В проде входные данные хаотичны. Пользователь мог нажать кнопку дважды, отправить пустую строку вместо числа или использовать браузер пятилетней давности. Ваша задача - перестать гадать и начать собирать доказательства.
Шаг 1. Воспроизведение и сбор фактов
Нельзя чинить то, что вы не можете повторить. Или хотя бы четко описать. Прежде чем писать строчку кода, ответьте на три вопроса:
- Что именно сломалось? Не «сайт тормозит», а «при нажатии кнопки „Оплатить“ возвращается ошибка 500».
- Когда это началось? После последнего деплоя? После обновления библиотеки? Или само собой?
- Кто затронут? Все пользователи или только те, кто использует Safari? Только новые аккаунты или старые тоже?
Если баг не воспроизводится стабильно (так называемый heisenbug), ваша главная цель - собрать максимум логов. Попросите тестировщиков или поддержку прислать ID пользователя, время запроса и точную ошибку из консоли браузера. Без этих данных вы будете работать вслепую.
Шаг 2. Читаем логи, а не гадаем
Логи - ваш лучший друг. Но многие новички игнорируют их или читают поверхностно. Ищите стектрейсы (stack traces). Это цепочка вызовов функций, которая привела к ошибке. Она покажет не только место падения, но и путь, по которому программа туда пришла.
Вот типичная ситуация: вы видите ошибку NullPointerException. Очевидно, что какая-то переменная равна null. Но где она стала null? Логи помогут проследить историю. Если вы используете современные системы мониторинга вроде Sentry или Datadog, там часто уже собрана вся информация об ошибке: версия приложения, параметры запроса, состояние памяти. Используйте эти инструменты по максимуму.
Совет из практики: никогда не используйте console.log или print для отладки в проде, если можно обойтись без этого. Эти методы замедляют систему и загрязняют логи. Лучше временно поднять уровень детализации логов (debug level) для конкретного модуля, если инфраструктура это позволяет.
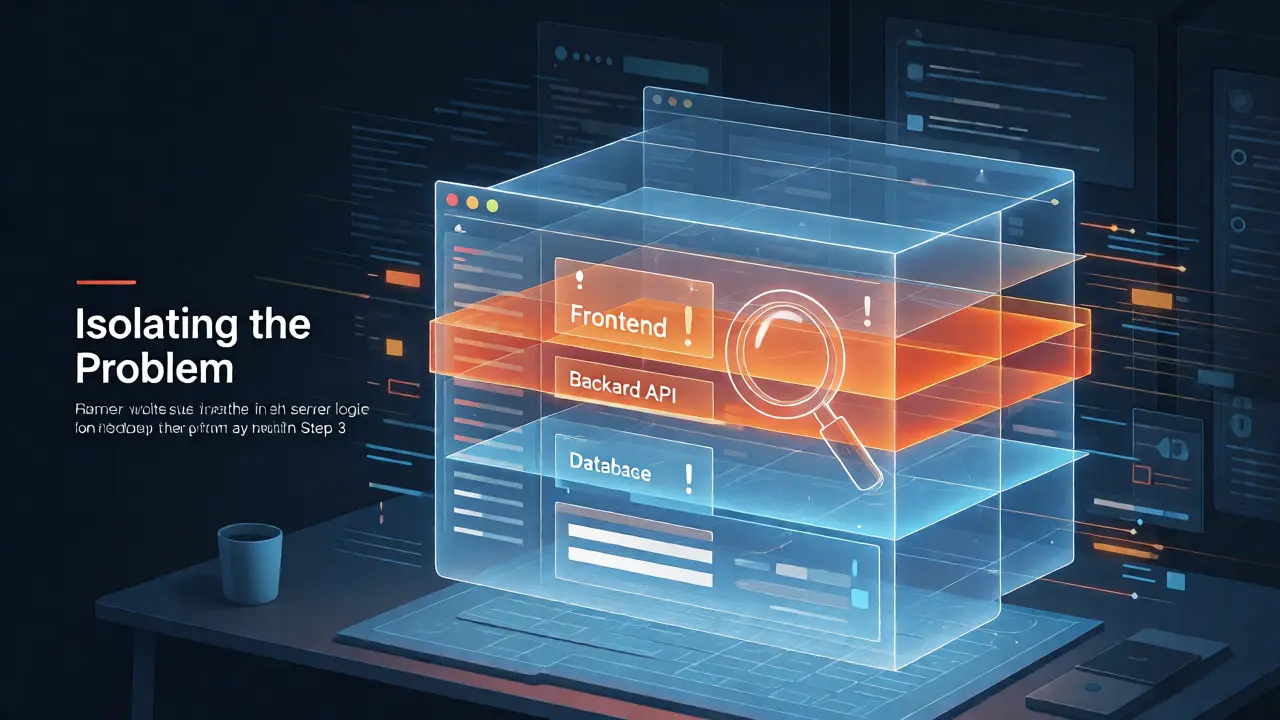
Шаг 3. Изоляция проблемы методом исключения
Допустим, вы нашли подозрительный кусок кода. Не спешите его править. Сначала изолируйте проблему. Попробуйте ответить на вопрос: является ли баг проблемой фронтенда, бэкенда или базы данных?
| Симптом | Вероятный слой | Инструмент проверки |
|---|---|---|
| Интерфейс не реагирует на клики | Frontend / JavaScript | DevTools в браузере |
| Ошибка 500 Internal Server Error | Backend / API | Серверные логи, Postman |
| Данные отображаются неверно или отсутствуют | Database / Query | SQL-запросы, ORM logs |
| Медленная загрузка страниц | Network / Infrastructure | Network tab, APM tools |
Если ошибка 500, значит, сервер упал. Проверьте, приходит ли запрос до сервера вообще. Иногда проблема в балансировщике нагрузки или неправильных настройках CORS, из-за которых браузер блокирует ответ. Метод бинарного поиска работает отлично: разделите систему на части и проверяйте каждую отдельно.
Шаг 4. Формулируем гипотезу и проверяем её
Теперь, когда у вас есть факты, сформулируйте гипотезу. Например: «Я думаю, что функция calculateTotal() падает, потому что получает отрицательное значение скидки, которое не обрабатывается».
Как проверить гипотезу в проде, не ломая всё вокруг? Есть несколько способов:
- Feature Flags (Флаги функций). Если у вас настроена система флагов, попробуйте отключить проблемную функциональность для небольшого процента пользователей. Если ошибки прекратятся - гипотеза верна.
- Canary Release. Выкатите исправление (или диагностический патч) на один сервер из кластера. Следите за метриками только этого сервера.
- Read-only доступ к данным. Сделайте дамп нужной таблицы или выполните SELECT-запрос в продакшене (осторожно!), чтобы увидеть реальные данные, на которых падает код.
Не бойтесь спрашивать. Опытные разработчики ценят тех, кто приходит с вопросом: «Я вижу вот такие логи, я предполагаю вот это, могу ли я проверить эту гипотезу так-то?». Это показывает вашу компетентность лучше, чем молчаливое тыканье в клавиши.
Шаг 5. Исправление и безопасный деплой
Нашли причину? Отлично. Теперь самое опасное - фикс. Правило №1: минимальное изменение. Не переписывайте весь класс ради одной строчки. Чем меньше изменений, тем меньше вероятность занести новый баг.
Обязательно напишите тест. Да, даже если вы торопитесь. Тест должен сначала падать на старом коде и проходить на новом. Это единственный способ гарантировать, что вы починили конкретную проблему, а не случайно изменили поведение системы.
Перед деплоем убедитесь, что у вас есть план отката (rollback plan). Что делать, если фикс не помог или сделал хуже? Вы должны знать, как быстро вернуть предыдущую версию. Обычно это занимает пару минут, но в состоянии стресса эти минуты кажутся часами.
Частые ловушки для новичков
За годы работы в Казани и общения с джунами я заметил повторяющиеся ошибки. Вот они:
- Игнорирование кеширования. Вы исправили код, задеплоили, а пользователь всё равно видит старую ошибку. Почему? Потому что CDN или браузер закэшировали статику или API-ответ. Всегда учитывайте TTL кеша.
- Различия в версиях зависимостей. На вашей машине стоит Node.js 18, а на проде - 16. Или наоборот. Разница в поведении библиотек может быть критичной.
- Проблемы с часовыми поясами. Баг проявляется только ночью или в выходные? Часто дело в том, что сервер пишет время в UTC, а клиент ожидает локальное время, или наоборот.
- Конкурентные гонки (Race Conditions). Ошибка возникает только при высокой нагрузке. Два потока одновременно пытаются обновить одну запись в БД. Локально вы редко создаете такую нагрузку.
Что делать, если баг невозможно воспроизвести локально?
Попробуйте подключиться к продакшену через SSH и выполнить скрипт диагностики прямо на сервере. Также проверьте, нет ли различий в конфигурации окружения (.env файлы). Часто помогает использование инструментов типа Docker, чтобы смоделировать prod-условия локально, скопировав образ контейнера.
Стоит ли править баг в проде напрямую?
Крайне не рекомендуется. Даже одна опечатка может остановить сервис. Исключение составляют экстренные хотфиксы, когда простой бизнеса стоит миллионы. Но даже тогда изменения должны быть минимальными и немедленно коммититься в Git после стабилизации ситуации.
Как объяснить менеджеру, почему поиск бага занял 5 часов?
Покажите свой процесс: сколько времени ушло на анализ логов, какие гипотезы были отвергнуты, какие шаги предприняты для изоляции проблемы. Прозрачность снижает напряжение. Менеджеры понимают, что debugging - это исследовательская деятельность, а не конвейерная сборка.
Какие инструменты помогают быстрее находить ошибки?
Sentry для агрегации ошибок, ELK Stack (Elasticsearch, Logstash, Kibana) для анализа логов, Prometheus/Grafana для мониторинга метрик. Также полезен Profiler в вашем IDE для локальной отладки производительности.
Что такое «технический долг» в контексте багов?
Это накопившиеся костыли и временные решения, которые делают код хрупким. Баги часто появляются именно там, где технический долг высок. Регулярный рефакторинг снижает количество таких сюрпризов.
Разбор багов в проде - это навык, который нарабатывается практикой. Каждый сложный случай делает вас увереннее. Главное - не паниковать, следовать алгоритму и всегда документировать найденное решение. Через полгода вы будете вспоминать этот страх перед продакшеном с улыбкой.