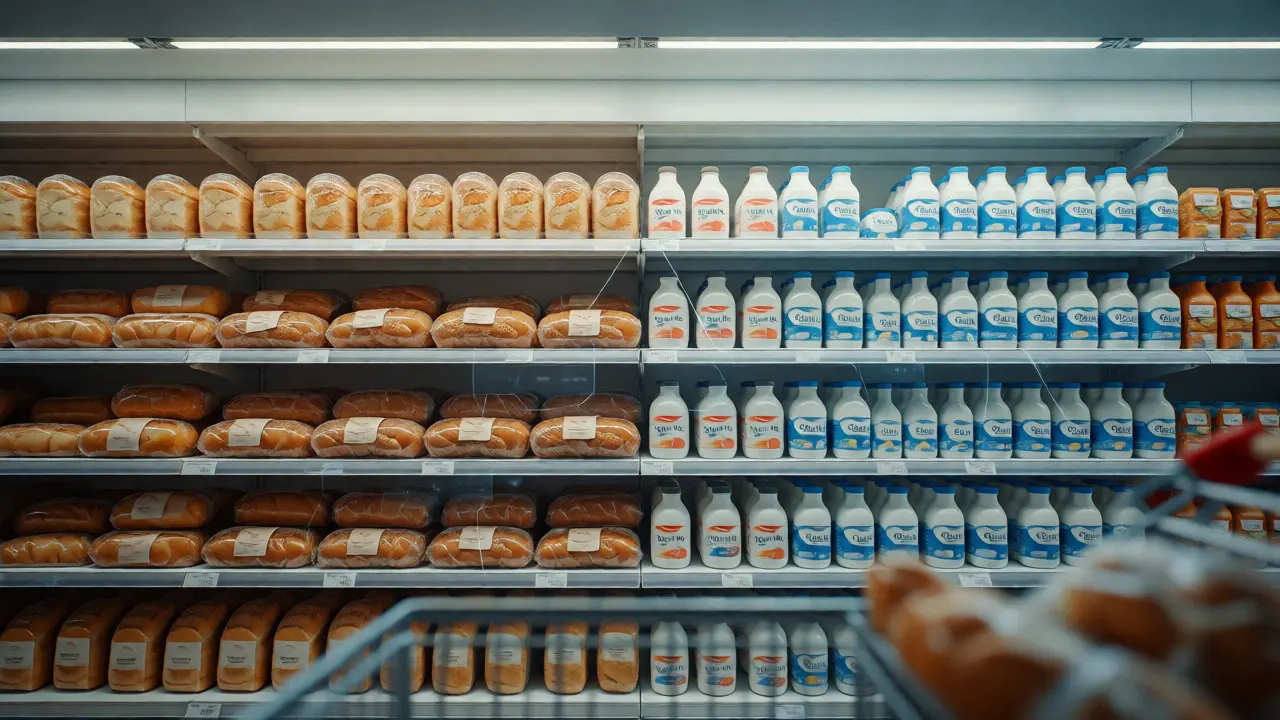
Вы когда-нибудь задумывались, почему в магазине хлеб всегда стоит рядом с молоком? Это не случайность и не каприз маркетолога. За этим решением стоят миллионы строк кода и сложные алгоритмы анализа потребительской корзины. Этот метод позволяет ритейлерам предсказывать поведение покупателей с пугающей точностью, превращая обычный поход за продуктами в хорошо спланированную операцию по увеличению среднего чека.
Но что скрывается за кулисами этой магии? Как компьютер понимает, что вы купите завтра? И главное - как эти знания помогают нам самим принимать более разумные решения при покупках? Давайте разберем механику процесса без лишнего академического шума, опираясь на реальные примеры из мира розничной торговли и data science.
Что такое потребительская корзина на самом деле
В бытовом понимании корзина - это то, что лежит у вас в тележке. В мире дата-сайенса, это набор транзакций или список товаров, которые покупатель приобрел за один визит. Ключевой момент здесь - именно «за один визит». Если вы пришли утром за кофе, а вечером за хлебом, для системы это две разные корзины. Почему это важно? Потому что контекст покупки меняет всё. Утренний кофе часто сопровождается круассаном, но редко сочетается с килограммом картошки.
Анализ этих наборов данных позволяет выявить скрытые закономерности. Например, статистика показывает, что вероятность покупки подгузников резко возрастает, если в корзине уже есть пиво. Звучит смешно, но этот кейс стал классикой благодаря анализу данных в Walmart в конце 90-х годов. Алгоритм обнаружил корреляцию: молодые отцы, отправленные женами за пивом, часто хватали подгузники «для галочки», чтобы оправдать поездку. Понимание таких связей позволяет перестроить полки так, чтобы облегчить жизнь покупателю (и наполнить карман магазина).
Как работают ассоциативные правила
Сердцем анализа потребительской корзины является концепция ассоциативных правил. Это базовый принцип машинного обучения, который формулирует связи между товарами в формате «Если А, то Б». Чтобы такие правила были полезными, они должны соответствовать трем критериям: поддержке, уверенности и лифту.
- Поддержка (Support): Показывает, насколько часто товары А и Б встречаются вместе во всех транзакциях. Если правило «Хлеб + Молоко» имеет поддержку 5%, это значит, что в каждой двадцатой покупке присутствуют оба продукта.
- Уверенность (Confidence): Вероятность того, что если человек купил товар А, он также купит товар Б. Здесь мы смотрим на условную вероятность. Высокая уверенность означает надежную связь.
- Лифт (Lift): Самый важный показатель. Он сравнивает реальную частоту совместных покупок с ожидаемой частотой, если бы товары выбирались независимо друг от друга. Лифт больше 1 означает положительную корреляцию (товары дополняют друг друга), меньше 1 - отрицательную (они заменяют друг друга), а равенство единице говорит об отсутствии связи.
Представьте, что вы продаете смартфоны и чехлы. Поддержка может быть низкой, потому что не все покупают телефон каждый день. Но уверенность будет высокой: почти каждый, кто берет новый iPhone, сразу же приобретает защитный кейс. Именно высокая уверенность делает эту пару ценной для рекомендательных систем, даже если абсолютное число таких покупок невелико.
Алгоритмы, которые находят золото в данных
Перебирать все возможные комбинации товаров вручную невозможно. В супермаркете может быть 10 000 позиций, количество возможных пар исчисляется миллионами, а троек - миллиардами. Тут на помощь приходят специализированные алгоритмы поиска частых множеств, такие как Apriori и FP-Growth.
Алгоритм Apriori работает по принципу «снизу вверх». Он начинает с поиска самых популярных одиночных товаров, затем формирует пары только из тех, что оказались популярными по отдельности, и так далее. Его слабое место - производительность на больших наборах данных, так как он требует многократно сканировать базу транзакций.
Более современный подход - FP-Growth (Frequent Pattern Growth). Вместо повторного сканирования базы он строит специальную структуру данных, называемую деревом FP, которая хранит информацию о частоте товаров компактно. Это позволяет находить паттерны значительно быстрее, особенно когда речь идет о глубоких цепочках покупок. Для крупных сетей вроде X5 Group или Магнит, обрабатывающих миллионы чеков ежедневно, выбор алгоритма напрямую влияет на скорость обновления рекомендаций на кассах самообслуживания.
Практическое применение: от полки до приложения
Зачем бизнесу тратить ресурсы на эти вычисления? Ответ прост: деньги. Анализ потребительской корзины решает три основные задачи.
| Задача бизнеса | Инструмент анализа | Ожидаемый результат |
|---|---|---|
| Кросс-продажи | Рекомендации «С этим товаром покупают» | Рост среднего чека на 10-15% |
| Планирование запасов | Прогнозирование спроса на связанные товары | Снижение потерь от просрочки на 5-8% |
| Ценообразование | Эластичность спроса по группам товаров | Оптимизация скидок на сопутствующие позиции |
Первый пункт - это то, что вы видите в интернет-магазинах Ozon или Wildberries. Когда вы кладете в корзину ноутбук, система мгновенно предлагает мышку, коврик и сумку. Эти предложения генерируются не людьми, а моделями, обученными на исторических данных миллионов других пользователей. Эффективность таких рекомендаций подтверждается тем, что до 30% выручки крупных e-commerce платформ приходится именно на подсказки алгоритмов.
Второй пункт касается логистики. Если алгоритм знает, что перед Новым годом продажи шампанского растут параллельно с мандаринами и оливками, склад заранее увеличивает запасы этих товаров в конкретных регионах. Это предотвращает ситуации, когда полки пустеют, а клиенты уходят к конкурентам.
Как использовать эти данные обычному человеку
Мы привыкли думать, что нас манипулируют. Но понимание принципов работы потребительской корзины дает вам преимущество. Вы можете стать более осознанным потребителем, используя те же логику, что и крупные сети.
Во-первых, обращайте внимание на ассоциации. Если вы видите, что два товара постоянно продаются вместе со скидкой, скорее всего, их себестоимость позволяет делать выгодные пакеты. Однако будьте осторожны: иногда «выгодная связка» включает в себя продукт с истекающим сроком годности. Проверяйте даты, даже если предложение выглядит привлекательно.
Во-вторых, используйте историю покупок для планирования бюджета. Многие банковские приложения и сервисы доставки еды (например, СберМаркет или Яндекс.Лавка) предоставляют аналитику ваших трат. Они могут показать, что в дни зарплаты вы склонны покупать деликатесы, а в середине месяца - бюджетные продукты. Осознание этого паттерна помогает корректировать расходы в реальном времени.
Наконец, не игнорируйте персонализацию. Если приложение рекомендует вам корм для кошек, хотя у вас нет питомца, возможно, вы просто забыли отметить это в профиле, или алгоритм ошибся на основе временной покупки подарка. Регулярная очистка истории или корректировка предпочтений «обучают» систему лучше понимать ваши реальные потребности, отсекая шум.
Будущее анализа: нейросети вместо простых правил
Классические ассоциативные правила хороши для простых связей («хлеб и масло»), но они плохо справляются с комплексными сценариями. Что если покупатель хочет приготовить ужин из трех ингредиентов, но еще не решил, какой именно рецепт выбрать? Здесь на сцену выходят глубокие нейронные сети и графовые модели.
Современные системы начинают учитывать не только сам факт покупки, но и время дня, погоду за окном, наличие промокодов и даже социальные тренды. Например, в жаркий день вероятность продажи мороженого растет экспоненциально, но только если в регионе еще не началась волна холодов. Гибридные модели, сочетающие правила и машинное обучение, позволяют предсказывать спрос с точностью до конкретного часа.
Для разработчиков и аналитиков это означает новые вызовы. Нужно уметь работать не только с табличными данными, но и с неструктурированной информацией: отзывами, фотографиями продуктов, видео-рецептами. Будущее за мультиканальной аналитикой, где онлайн-корзина синхронизируется с офлайн-покупками через карты лояльности, создавая единый цифровой профиль клиента.
Чем отличается анализ потребительской корзины от сегментации клиентов?
Сегментация делит людей на группы по демографии или поведению (например, «молодые мамы» или «студенты»). Анализ потребительской корзины фокусируется на связях между товарами внутри одной транзакции, независимо от того, кто ее совершил. Сегментация отвечает на вопрос «кто покупает», а анализ корзины - «что покупают вместе».
Насколько точны рекомендации на основе ассоциативных правил?
Точность зависит от объема данных и качества алгоритма. На больших массивах данных (как у крупных ритейлеров) точность предсказания следующего товара может достигать 70-80%. Однако для нишевых магазинов с малым потоком клиентов точность ниже, так как статистически значимых связей меньше.
Можно ли применять анализ корзины для малого бизнеса?
Да, безусловно. Даже небольшой кофейне полезно знать, что большинство посетителей берут капучино с круассаном. Это позволяет оптимизировать закупки выпечки и расстановку витрины. Для этого не нужны сложные серверы, достаточно простой таблицы Excel и базовых знаний статистики.
Что такое «пустая корзина» и зачем ее анализировать?
«Пустая корзина» в аналитике обычно относится к брошенным корзинам в интернет-магазинах. Анализ причин отказа от покупки (цена доставки, сложность оформления, поиск цены) критически важен для конверсии. Это отдельная задача, но она часто интегрируется в общий анализ поведения пользователя.
Как погода влияет на потребительскую корзину?
Погода является сильным внешним фактором. Дождь повышает спрос на зонты, готовую еду и алкоголь. Жара стимулирует продажи напитков, мороженого и солнцезащитных средств. Современные системы включают погодные данные как признак в модели прогнозирования, что позволяет динамически менять ассортимент и промо-предложения.